Konwertuj PDF na Markdown
Czysty Markdown zoptymalizowany pod LLM z plików PDF. Prosto w przeglądarce, bez wysyłania plików.
PDF, obsługiwane są też inne formaty
Upuść pliki tutaj
lub kliknij, aby wybrać, do 25 MB na plik, kilka naraz
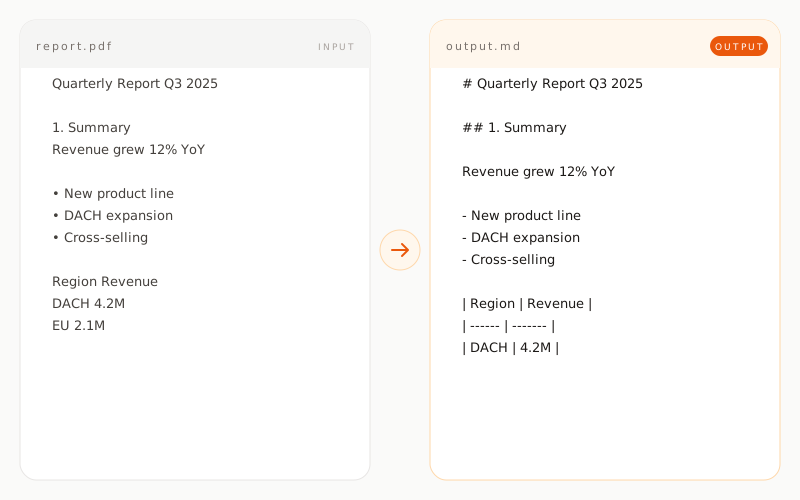
Przykład: PDF na Markdown
Raport kwartalny III kw. 2025

1. Podsumowanie
Przychody wzrosły o 12% rok do roku.
Główne czynniki:
• nowa linia produktów
• ekspansja w regionie DACH
• cross-selling

Region    Przychody
DACH      4,2 mln
UE        2,1 mln
# Raport kwartalny III kw. 2025

## 1. Podsumowanie

Przychody wzrosły o 12% rok do roku.

Główne czynniki:

- nowa linia produktów
- ekspansja w regionie DACH
- cross-selling

| Region | Przychody |
| ------ | --------- |
| DACH   | 4,2 mln   |
| UE     | 2,1 mln   |
Jak działa konwersja PDF?
PDF z warstwą tekstową
W przypadku plików PDF wygenerowanych cyfrowo osadzony strumień tekstu jest odczytywany bezpośrednio. Jest to szybkie, dokładne i bezstratne. Czcionki, rozmiary i kolory są celowo pomijane, bo Markdown to format semantyczny. Zostają nagłówki, akapity, listy i tabele w postaci, którą modele językowe takie jak Claude, ChatGPT czy Gemini mogą przetwarzać bezpośrednio. Typowy 20-stronicowy plik PDF konwertuje się w mniej niż dwie sekundy, w całości w przeglądarce.
Zeskanowane pliki PDF
Jeśli plik PDF zawiera tylko obrazy, czyli został zeskanowany, narzędzie wykrywa to automatycznie i uruchamia OCR przez Tesseract. OCR działa w całości w Twojej przeglądarce dzięki WebAssembly. Żadne dane nie są wysyłane na serwer. Jakość rozpoznawania zależy w dużej mierze od rozdzielczości skanu i języka źródłowego. Czyste skany w 300 DPI lub wyższej zwykle osiągają ponad 95 procent dokładności. Notatki odręczne nie są rozpoznawane wiarygodnie.
Układy wielokolumnowe i tabele
Prace naukowe, czasopisma i raporty często używają wielu kolumn. Narzędzie układa takie dokumenty w logiczną kolejność czytania od góry do dołu, dzięki czemu wynikowy Markdown czyta się spójnie. Tabele są odtwarzane jako prawidłowe tabele Markdown, o ile da się wykryć strukturę kolumn i granice komórek. Przy bardzo złożonych, zagnieżdżonych tabelach mogą wystąpić uproszczenia. W takich przypadkach zalecamy krótkie sprawdzenie wyniku wzrokowo.
Co zostaje zachowane, a co nie?
Kiedy warto konwertować PDF na Markdown?